Prompt Hotel Lobby AI: o texto exato que o MigosAI envia
Um prompt Hotel Lobby AI precisa resolver quatro coisas: prender cada foto a um lado, recriar a cabine laranja com o único microfone pendurado, fazer uma pessoa rimar enquanto a outra anima e deixar a câmera parada. Os dois prompts abaixo são o texto exato que o MigosAI (migosai.si) envia em todo vídeo da cabine: um para o Wan 3.0, que mantém a gravação do Hotel Lobby, e outro para o Seedance, que escreve um rap novo. No site você nunca digita nada disso; os prompts entram em ação quando você toca em Criar vídeo.
Mais abaixo há cinco prompts para outras ferramentas de imagem para vídeo que aceitam duas fotos e nenhum clipe de referência: um casal, dois amigos, avô ou avó com o neto, personagens desenhados e pets. Escrevemos esses cinco para esta página e não geramos vídeos com eles, então trate cada um como ponto de partida.
Atualizado em
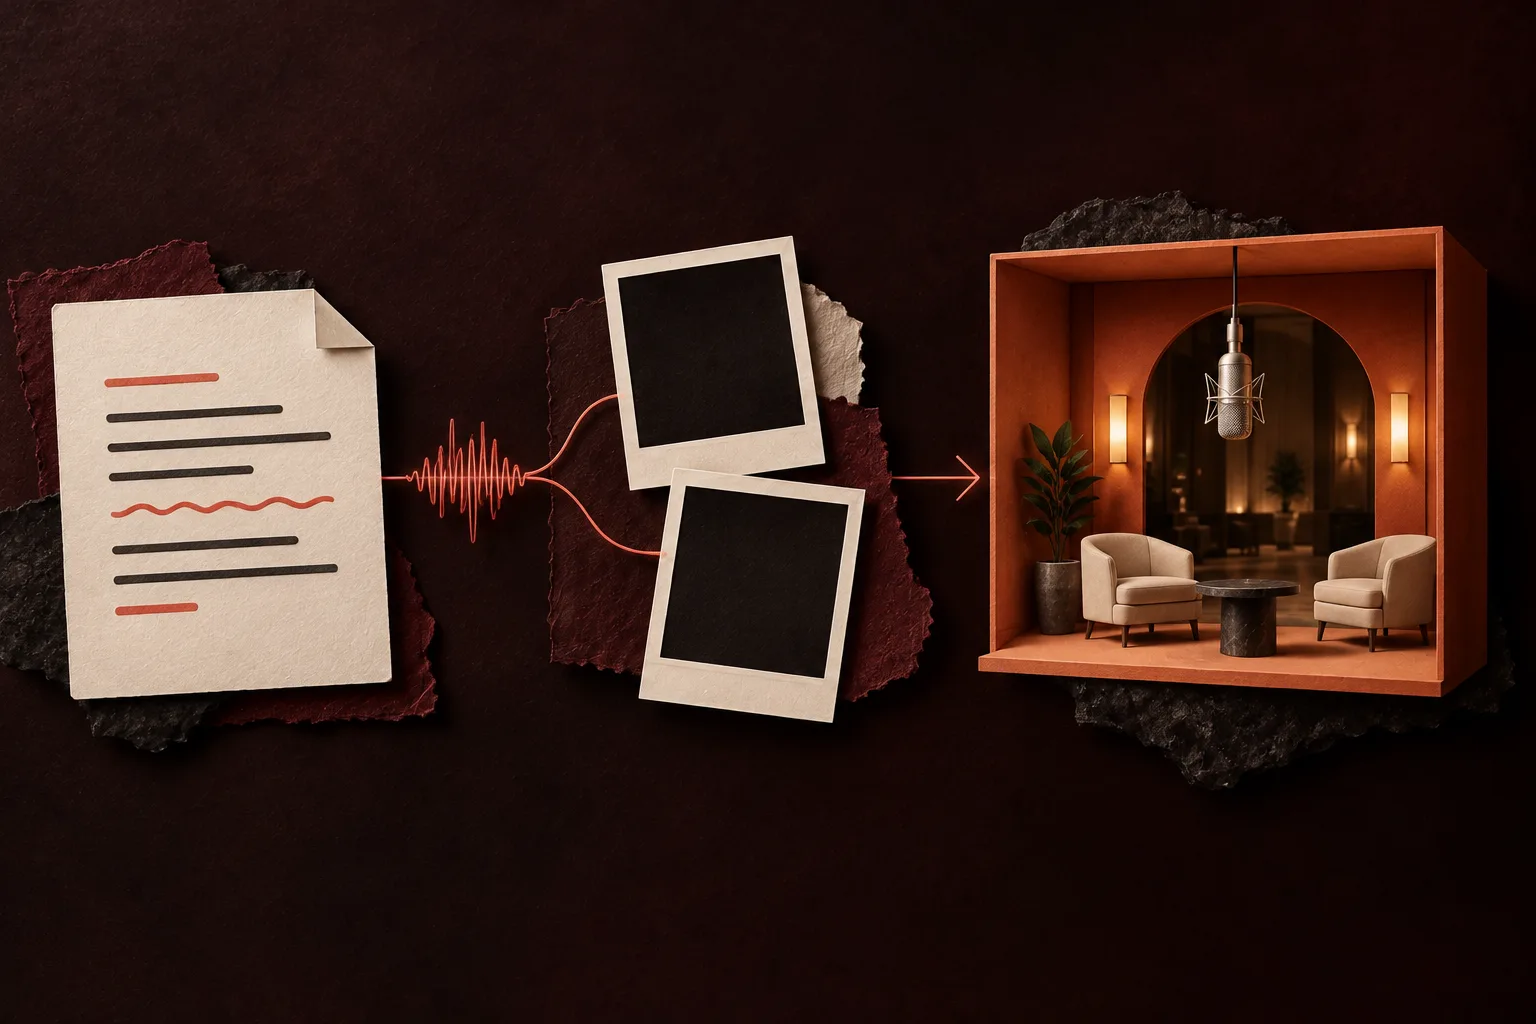
Prompt 1: Wan 3.0, mantendo a faixa do Hotel Lobby
O Wan 3.0 recebe quatro anexos, numerados na ordem de envio: Imagem 1 (a foto da esquerda), Imagem 2 (a foto da direita), Vídeo 1 (o clipe de referência do Hotel Lobby, sem som) e Áudio 1 (a faixa do Hotel Lobby, cortada na duração do vídeo). Antes da geração, cada foto vira um novo retrato de estúdio, de corpo inteiro e em pé, da mesma pessoa ou do mesmo animal, o que ajuda o modelo a segurar rostos e corpos; você só vê a sua foto original. A proporção não aparece no texto: ela vai para o modelo como uma configuração à parte, então este mesmo prompt serve para 9:16, 16:9 e qualquer outro formato.
Siga o Vídeo 1 do começo ao fim: copie o enquadramento, o ritmo e cada movimento, gesto, virada de cabeça, expressão facial e formato da boca, além do fundo laranja liso e do microfone prateado pendurado no teto entre os dois artistas. Mantenha o enquadramento de câmera do Vídeo 1: sem aproximar, sem afastar, sem panorâmica. Não acrescente nenhum movimento ou elemento de cena que não esteja no Vídeo 1.

Use o Áudio 1 como música de fundo do vídeo inteiro, exatamente como está: ele é todo o som do vídeo. Não escreva letra nova, não cante de novo, não acrescente outra música nem outras vozes.

O artista da esquerda é quem aparece na Imagem 1; o artista da direita é quem aparece na Imagem 2. Eles substituem por completo as duas pessoas do Vídeo 1: rosto, cabelo ou pelo, corpo e roupa vêm das fotos, nada das pessoas do Vídeo 1. Nenhum dos dois usa luvas (a não ser que já esteja de luvas na foto): pessoas mostram as próprias mãos e animais mantêm as próprias patas. Ignore o fundo das fotos.

O artista da esquerda faz o rap da voz do Áudio 1 no microfone, com a boca perfeitamente sincronizada com o Áudio 1. O da direita segue os movimentos da pessoa da direita no Vídeo 1: reage e gesticula no ritmo, mexendo a boca só em ad-libs curtos.

O laranja preenche o quadro inteiro, sem áreas pretas nem cantos escuros. Sem tela dividida, sem pessoas a mais, sem legendas nem texto na tela. Os rostos ficam iguais do começo ao fim.
O Wan recebe este texto em chinês, a língua que a documentação dele usa para nomear os anexos. O que aparece aqui é uma tradução para o português, frase por frase, desse original.
Prompt 2: Seedance, escrevendo um rap novo com IA
Os modelos Seedance não conseguem manter uma gravação: eles sempre geram a própria voz e a própria batida. Por isso, na cabine, a faixa do Hotel Lobby sobe como áudio de referência 1 só para marcar o ritmo, e o prompt pede uma batida nova nesse balanço, com letra nova sobre o tema que você digitou (são usados até 120 caracteres). Aqui os anexos são citados por extenso (“imagem de referência 1”). Esta cópia é a versão vertical de 12 segundos para o tema de exemplo “os 30 anos da Maya e a baliza terrível dela”.
Use o vídeo de referência 1 para a apresentação inteira: copie o enquadramento, o ritmo e cada movimento, gesto, virada de cabeça, expressão facial e movimento da boca, o fundo laranja liso e o único microfone prateado pendurado entre os artistas. Mantenha o enquadramento de câmera do vídeo de referência 1: sem aproximar, sem afastar, sem panorâmica. Não acrescente nenhum movimento ou elemento de cena que não esteja no vídeo de referência 1.

Artista da esquerda: a pessoa da imagem de referência 1. Artista da direita: a pessoa da imagem de referência 2. Eles substituem por completo as duas pessoas do vídeo de referência 1: rosto, cabelo, corpo e roupa vêm das fotos, nada das pessoas do vídeo de referência 1. Se uma foto não mostrar nenhuma roupa de uma pessoa (só o rosto ou os ombros nus), vista essa pessoa com roupas simples do dia a dia que combinem com ela, como uma camiseta lisa e jeans; nunca o figurino, a capa, o casaco, os cintos, as luvas ou a venda nos olhos das pessoas do vídeo de referência 1. Os animais ficam como estão, sem roupa. Ignore o fundo das fotos.

Trilha sonora: uma música original de trap sombrio de Atlanta feita para este vídeo que segue o áudio de referência 1 na batida e no ritmo: o mesmo andamento, groove, padrão de bateria e balanço, no tempo dos movimentos do vídeo de referência 1. Faça uma batida nova nesse estilo com letra nova; não reutilize a letra, a melodia nem as vozes do áudio de referência 1. Enxuto mas pesado: um 808 retumbante e áspero que desliza entre as notas, uma caixa com palmas cortante com hi-hats secos, e um único loop de melodia sinistra com toque oriental. Clima sombrio, ameaçador e confiante. O rap é um flow em tercinas rápido e com balanço por cima da batida lenta. Mixagem: a voz clara por cima, a batida logo atrás quase no mesmo volume, alta e marcante, nunca baixa e sem nunca parar entre uma frase e outra. O artista da esquerda faz no microfone pendurado um verso original e limpo sobre: "os 30 anos da Maya e a baliza terrível dela". Faça o rap no idioma desse tema. Voz de rap clara, boca sincronizada com cada palavra, movimentos naturais de cabeça e boca expressiva. O artista da direita é o parceiro que anima: aponta para quem está rimando, reage, sorri e solta ad-libs curtos no ritmo. Não use nenhuma música existente, nenhuma letra existente nem a voz de nenhum artista real.

9:16. O laranja preenche o quadro inteiro de ponta a ponta, sem áreas pretas ou escuras. Sem tela dividida, sem pessoas a mais, sem legendas nem texto na tela. Os rostos ficam iguais do começo ao fim.
Por que cada parágrafo está no prompt do Wan
| Parágrafo | Função | O que dá errado sem ele |
|---|---|---|
| 1. Seguir o Vídeo 1 | Copia enquadramento, ritmo, gestos, viradas de cabeça, expressões e formatos de boca, além da parede laranja e do microfone pendurado; proíbe zoom, panorâmica e elementos novos na cena | O modelo inventa outra sala ou um movimento de câmera, e faixas escuras surgem nas bordas |
| 2. Usar o Áudio 1 | Faz da faixa o único som e proíbe reescrever ou cantar de novo | Música nova, vozes extras ou palavras inventadas |
| 3. Quem é quem | Liga a Imagem 1 à esquerda e a Imagem 2 à direita, tira rosto, cabelo ou pelo, corpo e roupa das fotos, descarta o fundo delas e proíbe luvas, a menos que a foto tenha | Lados trocados, um rosto do clipe de referência vazando, ou as luvas dos dançarinos originais copiadas em mãos e patas sem luva |
| 4. Os papéis | Quem está à esquerda rima o Áudio 1 com lip sync; quem está à direita copia o parceiro que anima e só mexe a boca em ad-libs curtos | As duas bocas mexendo ao mesmo tempo, ou um parceiro parado feito poste |
| 5. Proteções | Laranja de ponta a ponta, sem tela dividida, sem pessoas extras, sem legendas, rostos estáveis | Cantos escuros, uma terceira pessoa, legenda gravada na imagem, rostos que mudam no meio do clipe |
A linguagem é neutra de propósito. “Quem aparece na Imagem 1” serve para uma avó, um bebê no colo do pai ou da mãe ou um beagle sem contradizer a foto, então o mesmo texto funciona para qualquer dupla.
Como usar estes prompts em outra ferramenta de vídeo com IA
- Veja o que a ferramenta aceita. O Prompt 1 pede quatro anexos (duas imagens, um vídeo e um áudio, todos de referência) e um modelo que toque esse áudio sem mexer nele. Muitas ferramentas só aceitam fotos; nesse caso, pule para os cinco prompts de duas fotos mais abaixo.
- Renomeie os anexos. Aqui eles são numerados na ordem de envio; algumas ferramentas pedem tags como @Image1 ou nomes próprios. Em qualquer caso, envie primeiro a foto da esquerda.
- Defina o formato nas configurações da ferramenta, não no texto: 9:16 para TikTok e Reels, 16:9 para YouTube.
- Se o modelo compõe a própria música, a linha que manda usar o Áudio 1 como está não vai ser respeitada. Siga a lógica do Prompt 2 e peça um rap novo.
- Mantenha as linhas negativas. “Sem pessoas a mais”, “sem legendas” e “ignore o fundo das fotos” evitam a maioria das tentativas perdidas em qualquer ferramenta.
- Use uma gravação que você tem direito de usar e fotos de pessoas que toparam aparecer no vídeo.
- Algumas ferramentas publicam prompts só de texto. O Dreamina (CapCut) tem prompts de Hotel Lobby para copiar e colar, para duas fotos no Seedance 2.5 (conferido em 6 de outubro de 2026).
Cinco prompts Hotel Lobby AI para quem só tem duas fotos
A maioria das ferramentas de imagem para vídeo voltadas ao público aceita só fotos e texto. Sem clipe de referência, o prompt precisa descrever sozinho a cabine e os movimentos. Estes cinco fazem isso e mantêm as regras que fazem um clipe parecer Hotel Lobby: uma pessoa de cada lado, um microfone pendurado entre elas, uma conduz e a outra anima, e a câmera nunca se mexe. Todos estão em 9:16 e 12 segundos; mude os dois valores no texto se a sua ferramenta pedir outros. Eles ficam em inglês, do jeito que foram escritos. Conte com uma ou duas tentativas a mais.
Prompt Hotel Lobby AI para casal
Vertical 9:16 video, 12 seconds, built from two reference photos. Left side: the person from image 1. Right side: the person from image 2. Show both from head to shoes and keep each face, hairstyle, outfit and height true to the photos. Scene: an empty studio painted solid orange, walls and floor the same shade, lit softly and evenly. A single silver studio microphone dangles on a thin cable from the ceiling, at mouth height, halfway between them. The couple performs a rap duet: the left partner leans into the microphone and raps with sure, rhythmic hand moves; the right partner grins, points at the rapper, bounces to the beat and leans in to share the mic for the final line. Static camera at chest height, one unbroken take, no zoom or pan. Nobody else in frame, no on-screen words, no logos.Para dois melhores amigos (eles trocam no meio)
Vertical 9:16 video, 12 seconds, from two reference photos of two adult friends. The friend in image 1 stands on the left and the friend in image 2 on the right, both visible head to toe, each face, haircut, outfit and build matching the photos. Plain orange studio: an orange backdrop that curves into an orange floor, one silver microphone hanging from the ceiling between them. Seconds 0 to 6: the left friend takes the microphone and raps while the right friend nods, laughs and hypes with big arm moves. Seconds 6 to 12: they switch, the right friend takes the microphone and the left friend reacts. Each one moves in their own way, never as a mirror image. Locked camera, single continuous shot, soft even light, feet in frame. No extra people, no props, no captions, no logos.Para avô ou avó com o neto
Vertical 9:16 video, 12 seconds, from two reference photos. Image 1 shows a grandparent, who stands on the left; image 2 shows their adult grandchild, who stands on the right. Full-length view of both, with each face, hairstyle, outfit and height kept as in the photos. Setting: a bare orange studio with a single silver microphone hanging from the ceiling in the middle. The grandparent raps into the microphone with calm, steady, self-assured gestures and a small smile; the grandchild reacts with surprise, laughs, dances on the beat and leans in so they rap the last line together. Gentle, natural movement that suits each age. Fixed camera, one take, even studio light, no cuts, zoom or pan, nobody else in the shot, no on-screen text.Para personagens desenhados ou de anime
Use personagens criados por você ou cujos direitos você tem. Personagem famoso tem dono.
Vertical 9:16 video, 12 seconds, from two reference images of original drawn characters. Character from image 1 on the left, character from image 2 on the right, both shown full figure. Keep each design exactly: line style, palette, proportions and clothing. Animate both in that same art style instead of turning them photo-real. They stand in a solid orange studio; a silver microphone dangles from the ceiling between them. The left character leans into it and raps with lively, exaggerated hand moves; the right character bobs on the beat, points and reacts with big expressions. Fixed camera, one continuous take, no cuts, zoom or pan. No other characters, no text, no logos.Prompt Hotel Lobby AI para pets
Dê a cada animal uma foto nítida própria, com o corpo inteiro aparecendo. Para um pet ao lado do dono, troque no texto o animal da direita por “the person in image 2”. Gatos e cachorros estiveram entre os primeiros clipes virais, feitos com outras ferramentas (veja a seleção).
Vertical 9:16 video, 12 seconds, from two reference photos of animals. The animal in image 1 is on the left and the animal in image 2 is on the right, both standing upright on their back legs, seen from ears to paws. Keep each one’s breed, markings, fur color, eye color, size and collar exactly as photographed. Scene: an empty orange studio, a silver microphone dangling from the ceiling at head height between the two. The left animal opens and closes its mouth on the beat and gestures with its front paws like a rapper at the mic; the right animal nods, glances at the camera and sways to the beat. Realistic anatomy: four legs and one tail each, no human hands. One fixed shot without cuts. No people, no other animals, no text.No MigosAI você pula tudo isso: o prompt, o clipe de referência e a faixa já vêm prontos, e a página de vídeo de rap com pet abre o gerador preparado para um pet e a dupla dele. Com animais, o resultado varia mais do que com pessoas.
Quando o vídeo sai errado
| O que você vê | Causa provável | O que tentar |
|---|---|---|
| O rosto parece de um estranho | Foto de perfil, óculos escuros, filtro pesado ou rosto minúsculo numa foto de grupo | Uma foto de frente, com luz uniforme, da cintura para cima ou de corpo inteiro |
| Esquerda e direita trocadas | Fotos enviadas na ordem errada, ou um prompt que nunca nomeia os lados | Envie primeiro quem rima e nomeie os dois lados no texto |
| Surge uma terceira pessoa | O modelo manteve alguém do clipe de referência ou do fundo de uma foto | Deixe no texto “ignore o fundo das fotos” e “sem pessoas a mais” |
| Legendas ou palavras soltas na tela | O modelo colocou legendas por conta própria | Deixe no texto “sem legendas nem texto na tela” |
| Boca fora de sincronia | Nenhum áudio anexado, ou o corte começa numa pausa | Anexe a faixa e comece o corte numa palavra cantada |
| Bordas escuras em volta do laranja | Um zoom ou uma panorâmica que o clipe de referência não tem | Segure o enquadramento e peça laranja de ponta a ponta |
| Uma música nova no lugar da faixa | O modelo sempre compõe a própria trilha | Troque para um modelo que reproduz a faixa de referência, como o Wan 3.0 |
Ou deixe o MigosAI cuidar do prompt
No MigosAI você adiciona duas fotos (ou uma de vocês dois em “Uma foto”), escolhe o som em Trilha e movimentos e toca em Criar vídeo. Um vídeo de 12 segundos no Wan 3.0 em 480p custa 6 créditos, o menor pacote é de 10 créditos por $9.99, e a geração costuma levar cerca de 5 a 15 minutos. Não há teste grátis. Se uma geração falhar, os créditos voltam para o seu saldo sozinhos.
Perguntas
Posso colar o prompt Hotel Lobby AI no ChatGPT?
Um assistente de chat pode editar o texto para você, mas o vídeo precisa sair de um modelo de vídeo. Cole o Prompt 1 numa ferramenta que aceite imagens, vídeo e áudio de referência, ou um dos prompts de duas fotos numa ferramenta de imagem para vídeo.
Para qual modelo o prompt do Hotel Lobby foi escrito?
O Prompt 1 roda no Wan 3.0, que mantém a faixa de referência. O Prompt 2 roda nos modelos Seedance 2.0 Mini, 2.0 Fast, 2.0 e 2.5, que escrevem o próprio rap. Outros modelos podem pedir outros nomes de anexo e talvez nem aceitem áudio.
Em que idioma está o prompt?
O MigosAI envia ao Wan 3.0 o original em chinês e ao Seedance o texto em inglês. Nesta página os dois aparecem traduzidos para o português, frase por frase, para você entender cada linha. Os cinco prompts de duas fotos ficam em inglês, como foram escritos.
Existe prompt Hotel Lobby AI para cachorro ou gato?
Existe: o prompt de pets acima, com uma foto por animal, cada um preso a um lado, em pé nas patas traseiras e com anatomia realista. No MigosAI nenhum prompt é necessário; a página de vídeo de rap com pet prepara o gerador para um pet.
Os prompts de duas fotos mantêm a música original de Hotel Lobby?
Não. Sem faixa de referência, é a ferramenta que decide o som, se fizer algum. Coloque no editor uma música que você tem direito de usar, ou use uma ferramenta que aceite áudio de referência.
Preciso escrever um prompt no MigosAI?
Não. O prompt já vem embutido. O único texto que você digita é um tema opcional para o rap num modelo Seedance, com até 120 caracteres, em qualquer idioma.
Fontes
Leia em seguida
Como fazer a trend do Hotel Lobby (Migos AI) passo a passo
Três jeitos de fazer a trend do Hotel Lobby (Migos AI): duas fotos no MigosAI, outro app de IA ou edição na mão, com custos, tempo de espera, prós e contras
Melhores fotos para Hotel Lobby AI: o que enviar
Um guia de fotos para a cabine: as regras do envio, o que ajuda o rosto a se manter, como o redesenho de corpo inteiro trata a sua foto e o que fazer com fotos difíceis
Hotel Lobby AI com seus passos: guia do vídeo de referência
Grave, corte e envie como Seu clipe: como um vídeo de referência guia a apresentação, qual som toca, quanto custa e onde ele deixa a desejar
Melhores geradores de vídeo Hotel Lobby AI (out. 2026)
Catorze geradores de vídeo Hotel Lobby AI comparados pelas próprias páginas em 6 de outubro de 2026, MigosAI incluído: como cada um funciona, o som, o vídeo mais barato e o que sai de graça
O MigosAI é uma ferramenta independente, sem vínculo com Migos, Quavo, Takeoff, Offset, Quality Control Music, Motown ou COLORS.